 CloosphereAll Your AI, Securely Managed in One Place.
製品・データ
社内文書と運用データを根拠に回答します
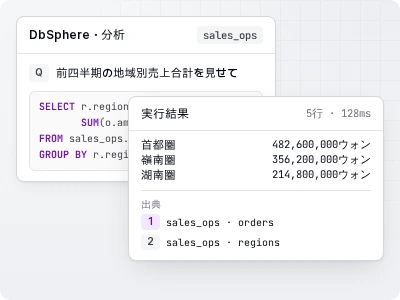
社内文書はナレッジベースへ、運用データはデータ分析へ、組織固有の用語は用語集へとつなげます。回答とあわせて、参照した文書、照会したデータベース、実行したSQLを示すため、結果の根拠を確認できます。
社内文書はナレッジベースへ KB
運用データベースはデータ分析へ SQL
回答ごとに引用文書・実行SQL CITE
社内データをAIに活用する際に直面する3つの課題
データの照会に時間がかかります
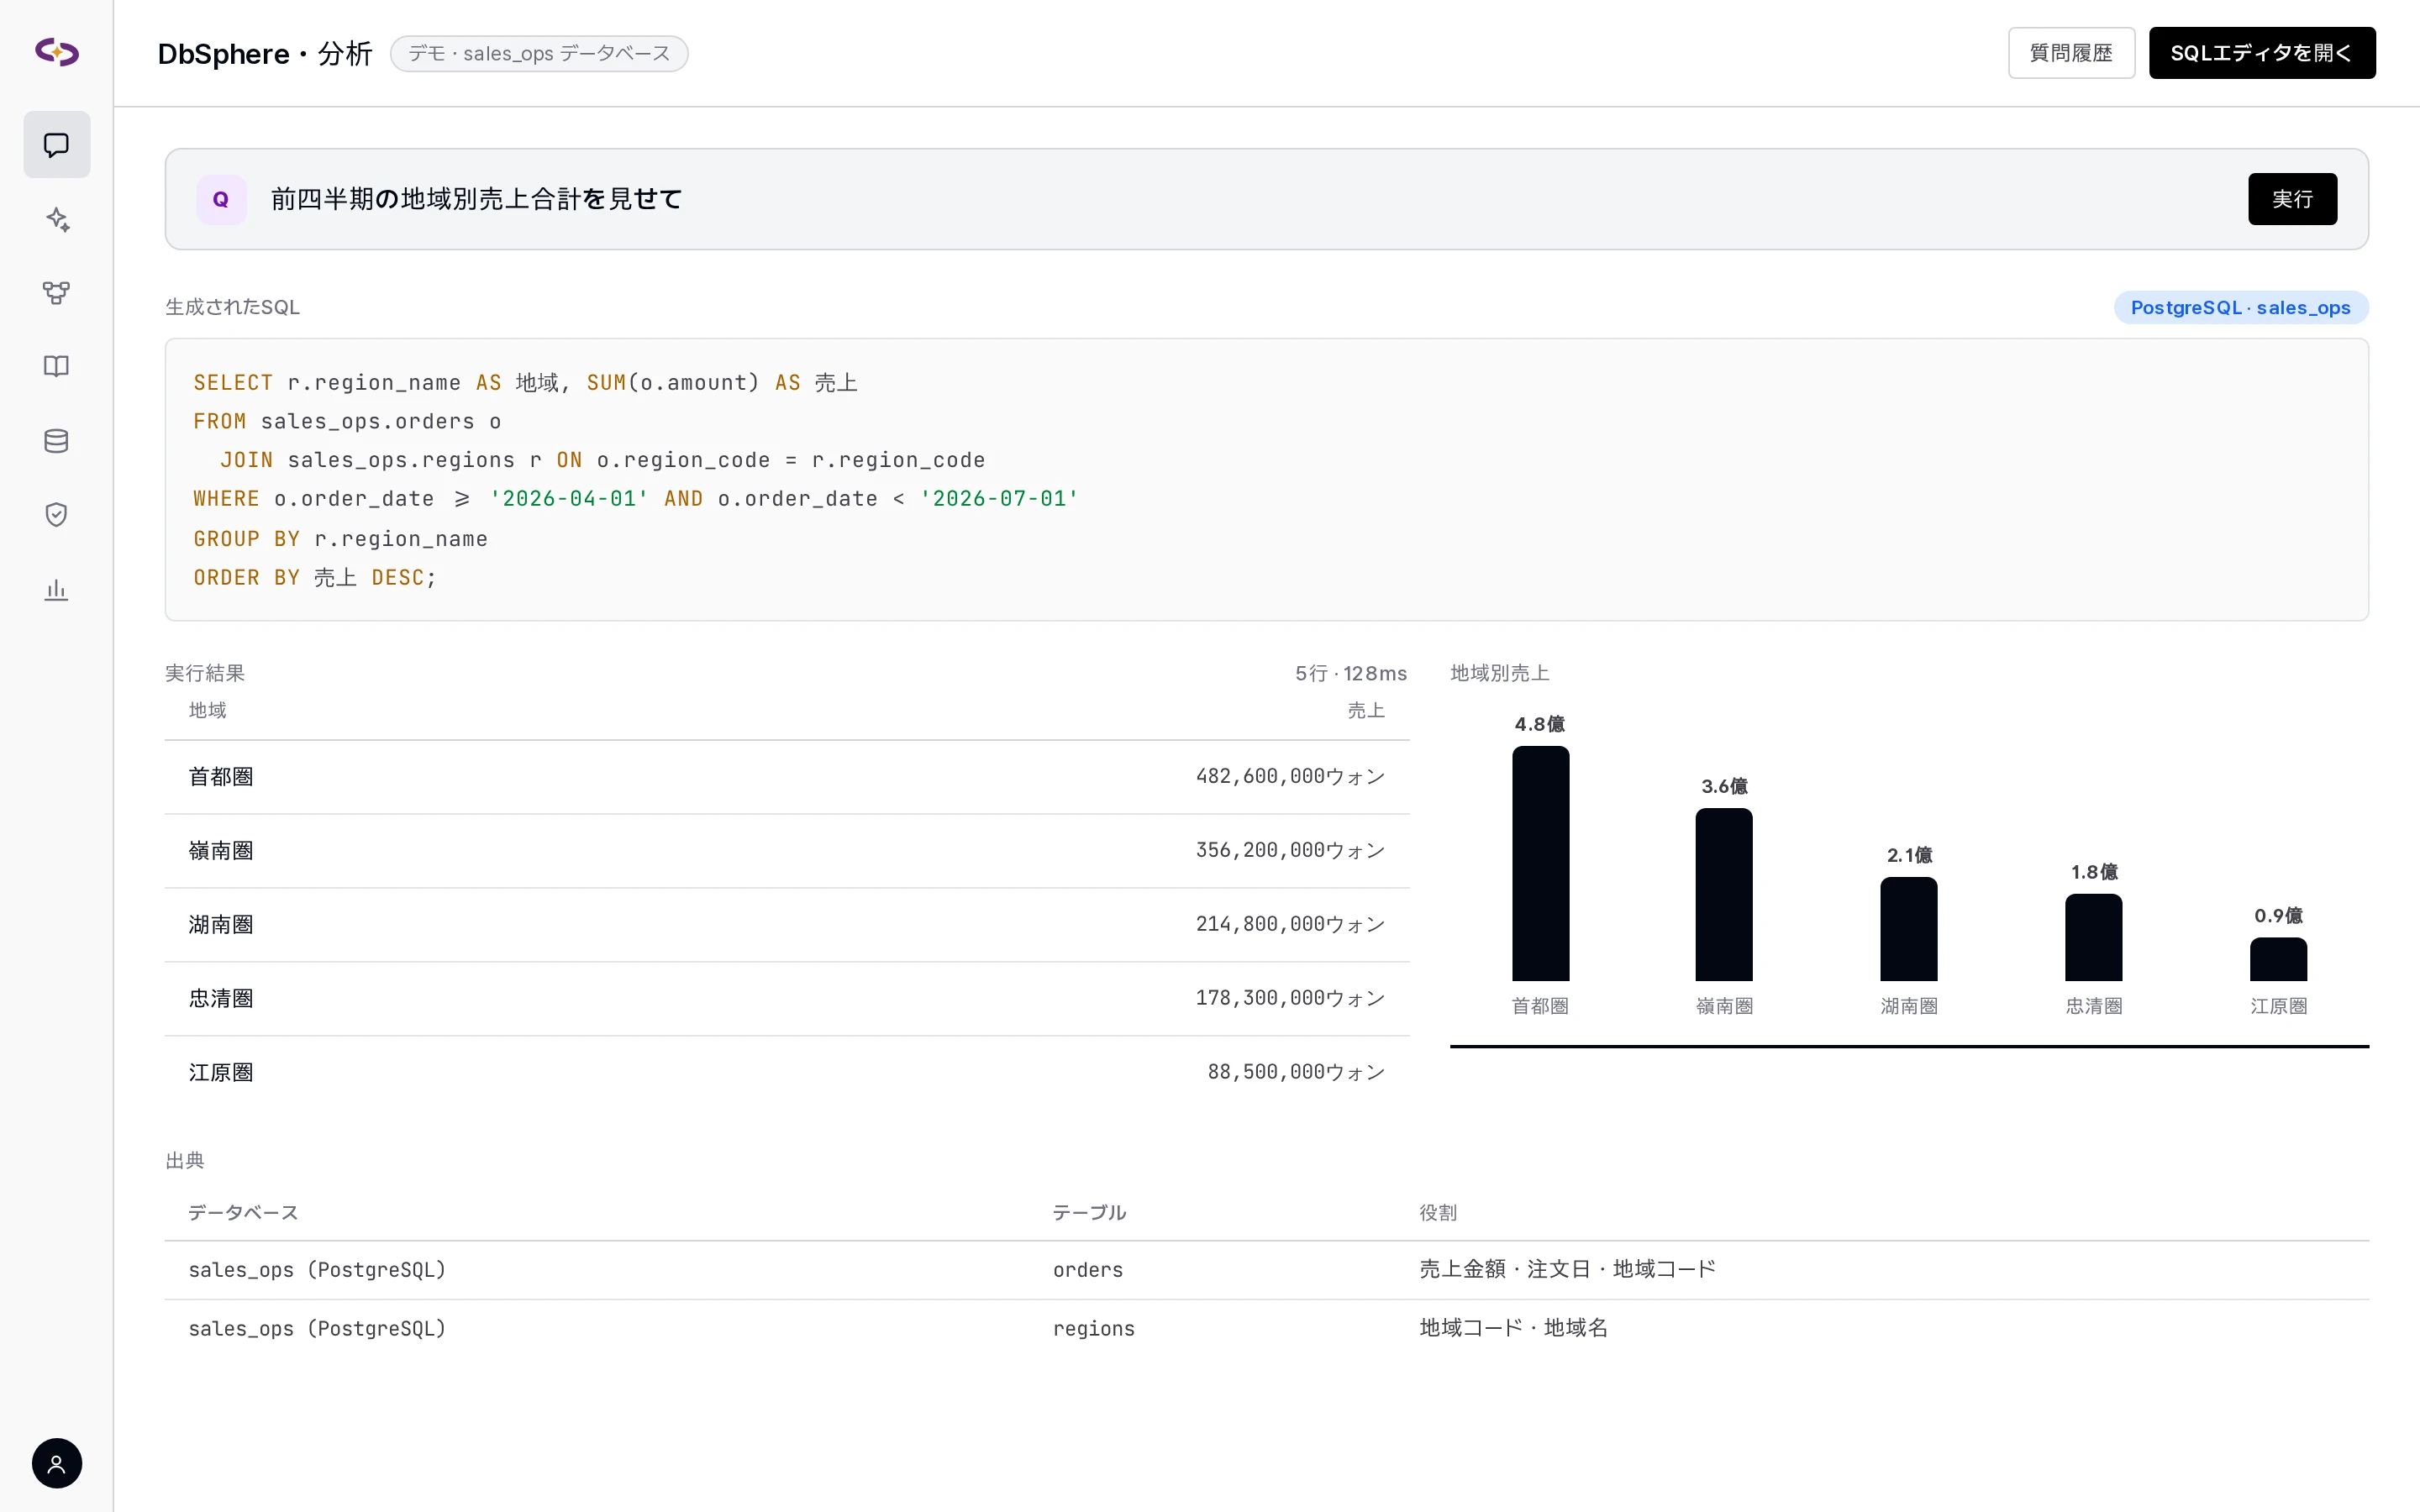
現場のユーザーが自然言語で質問すると、AIがSQLを生成してデータベースを照会し、結果を表とグラフで提供します。照会に使ったSQLも併せて確認できます。
組織固有の用語が回答に反映されません
「VIP顧客」「純売上」のような社内用語と定義、同義語を用語集に登録し、回答とSQL生成に一貫して反映します。
HWPファイルやスキャン文書は一貫して処理しにくいのが現状です
HWP・HWPXを含む14種類以上の文書形式に対応し、文書の形式や特性に応じて適切な抽出・OCRエンジンを適用できます。
文書とデータベースを根拠にする機能
ナレッジベース
- 対応形式: PDF・Word・PowerPoint・Excel・CSV・HWP・HWPX・Markdown・HTML・XML・EPUB・メール(EML・MSG)・TXT・JSONとコードファイル50種類以上。
- 拡張子ごとの抽出エンジン指定: 拡張子ごとにエンジンを選びます。例) PDFはAzure Document Intelligence、Excelは内蔵抽出エンジン。スキャン文書・画像はLLM Visionで処理します。指定のない形式は他のエンジンで任意に処理されず、アップロード段階で拒否されます。
- 検索: キーワードとベクトルを組み合わせたハイブリッド検索とリランキング、意味単位のチャンク分割。
- ライブラリ: ナレッジベースをフォルダツリーで整理し、エージェントが検索する範囲と「このフォルダをいつ検索するか」の説明をフォルダ単位で指定します。
- 一括処理: フォルダ単位のアップロード、重複ファイルの検知、同名ファイルの自動置き換え、失敗ファイルの再試行。処理の進捗は通知センターで確認でき、他の画面に移動しても維持されます。
データ分析 — 自然言語 → SQL
- データベース8種: PostgreSQL · MySQL / MariaDB · Microsoft SQL Server · Oracle · Snowflake · Databricks · Google BigQuery · Azure Synapse。
- 接続テスト: 保存前に接続テストボタンでテーブル一覧まで確認できます。BigQueryはキーファイルなしでGoogle Cloudのデフォルト認証を使用し、Oracleは読み取り専用アカウントや他スキーマの参照にも対応します。
- 回答: 質問 → SQL作成・実行 → 表・グラフ・要約。実行したすべてのSQLと結果が回答ステップに渡され、フィルターや集計基準を正確に説明します。
- 複数DB接続: エージェントに複数のDBを接続すると、どのDBをなぜ選び、何を照会したかが回答とSQL実行カードに表示されます。
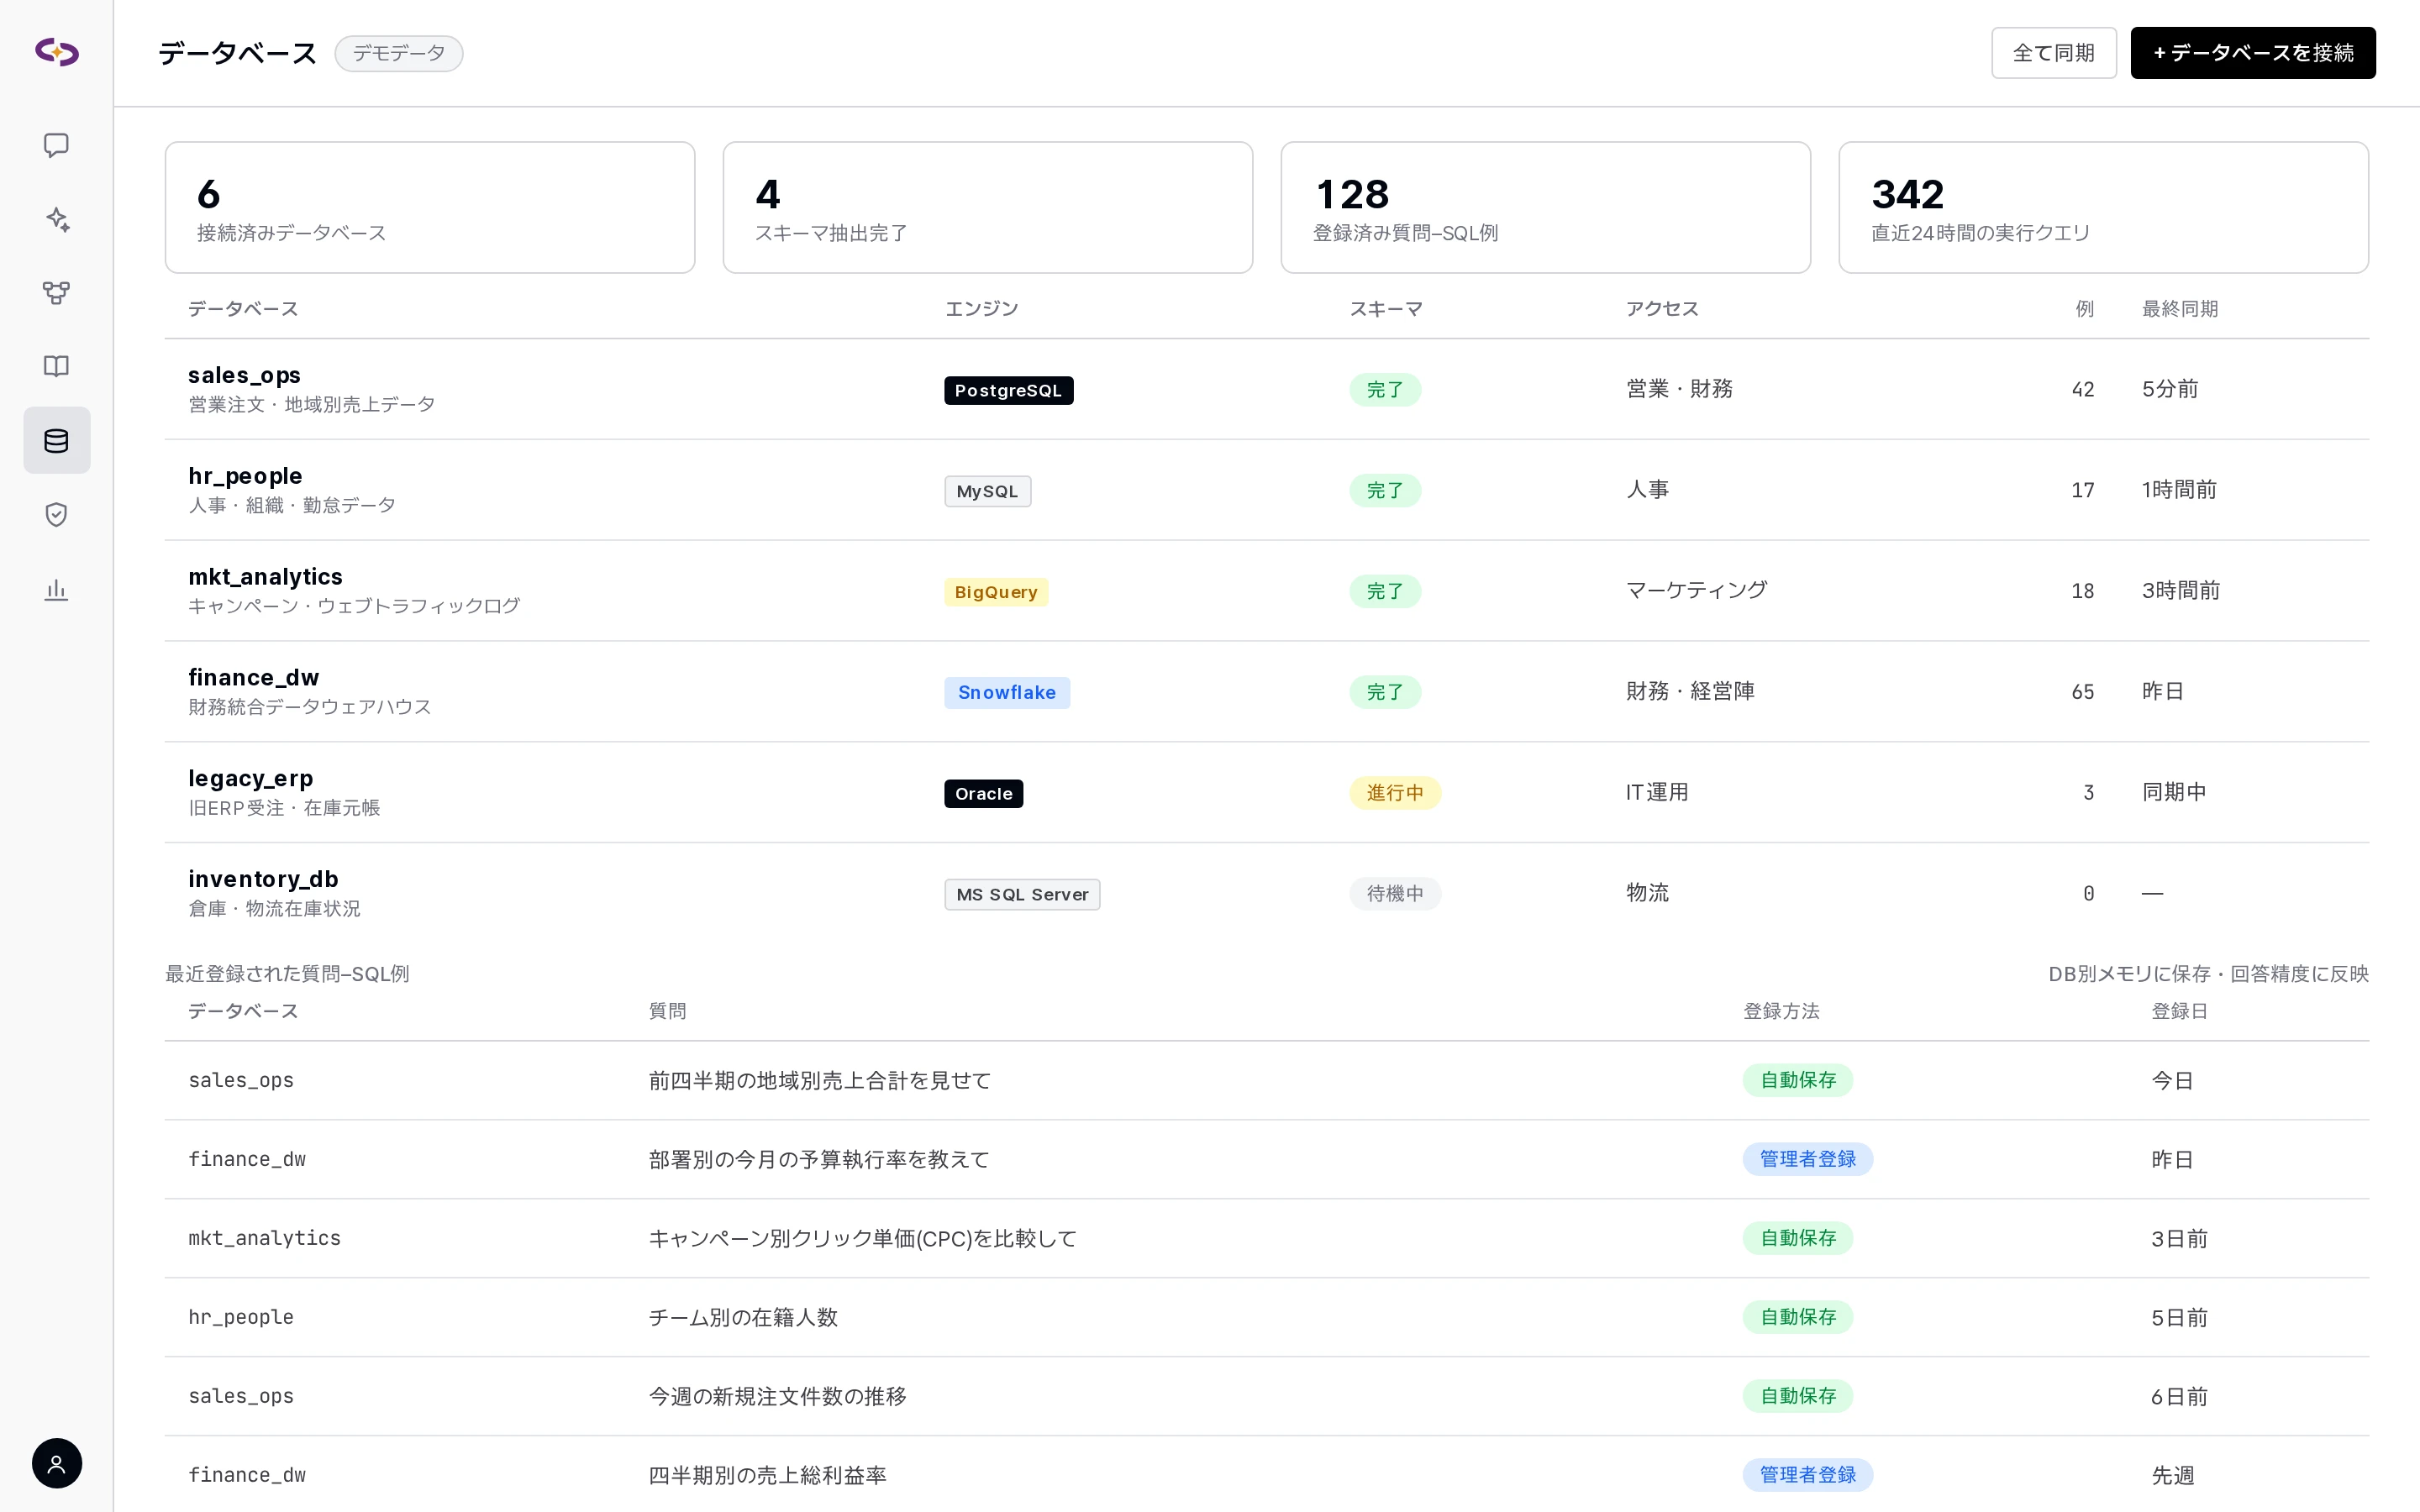
- 質問–SQL例メモリ: 検証済みの質問–SQL例をDBごとに蓄積して精度を高めます。回答の根拠が確認できたSQLのみ自動保存され、管理者が直接登録・修正することもできます。
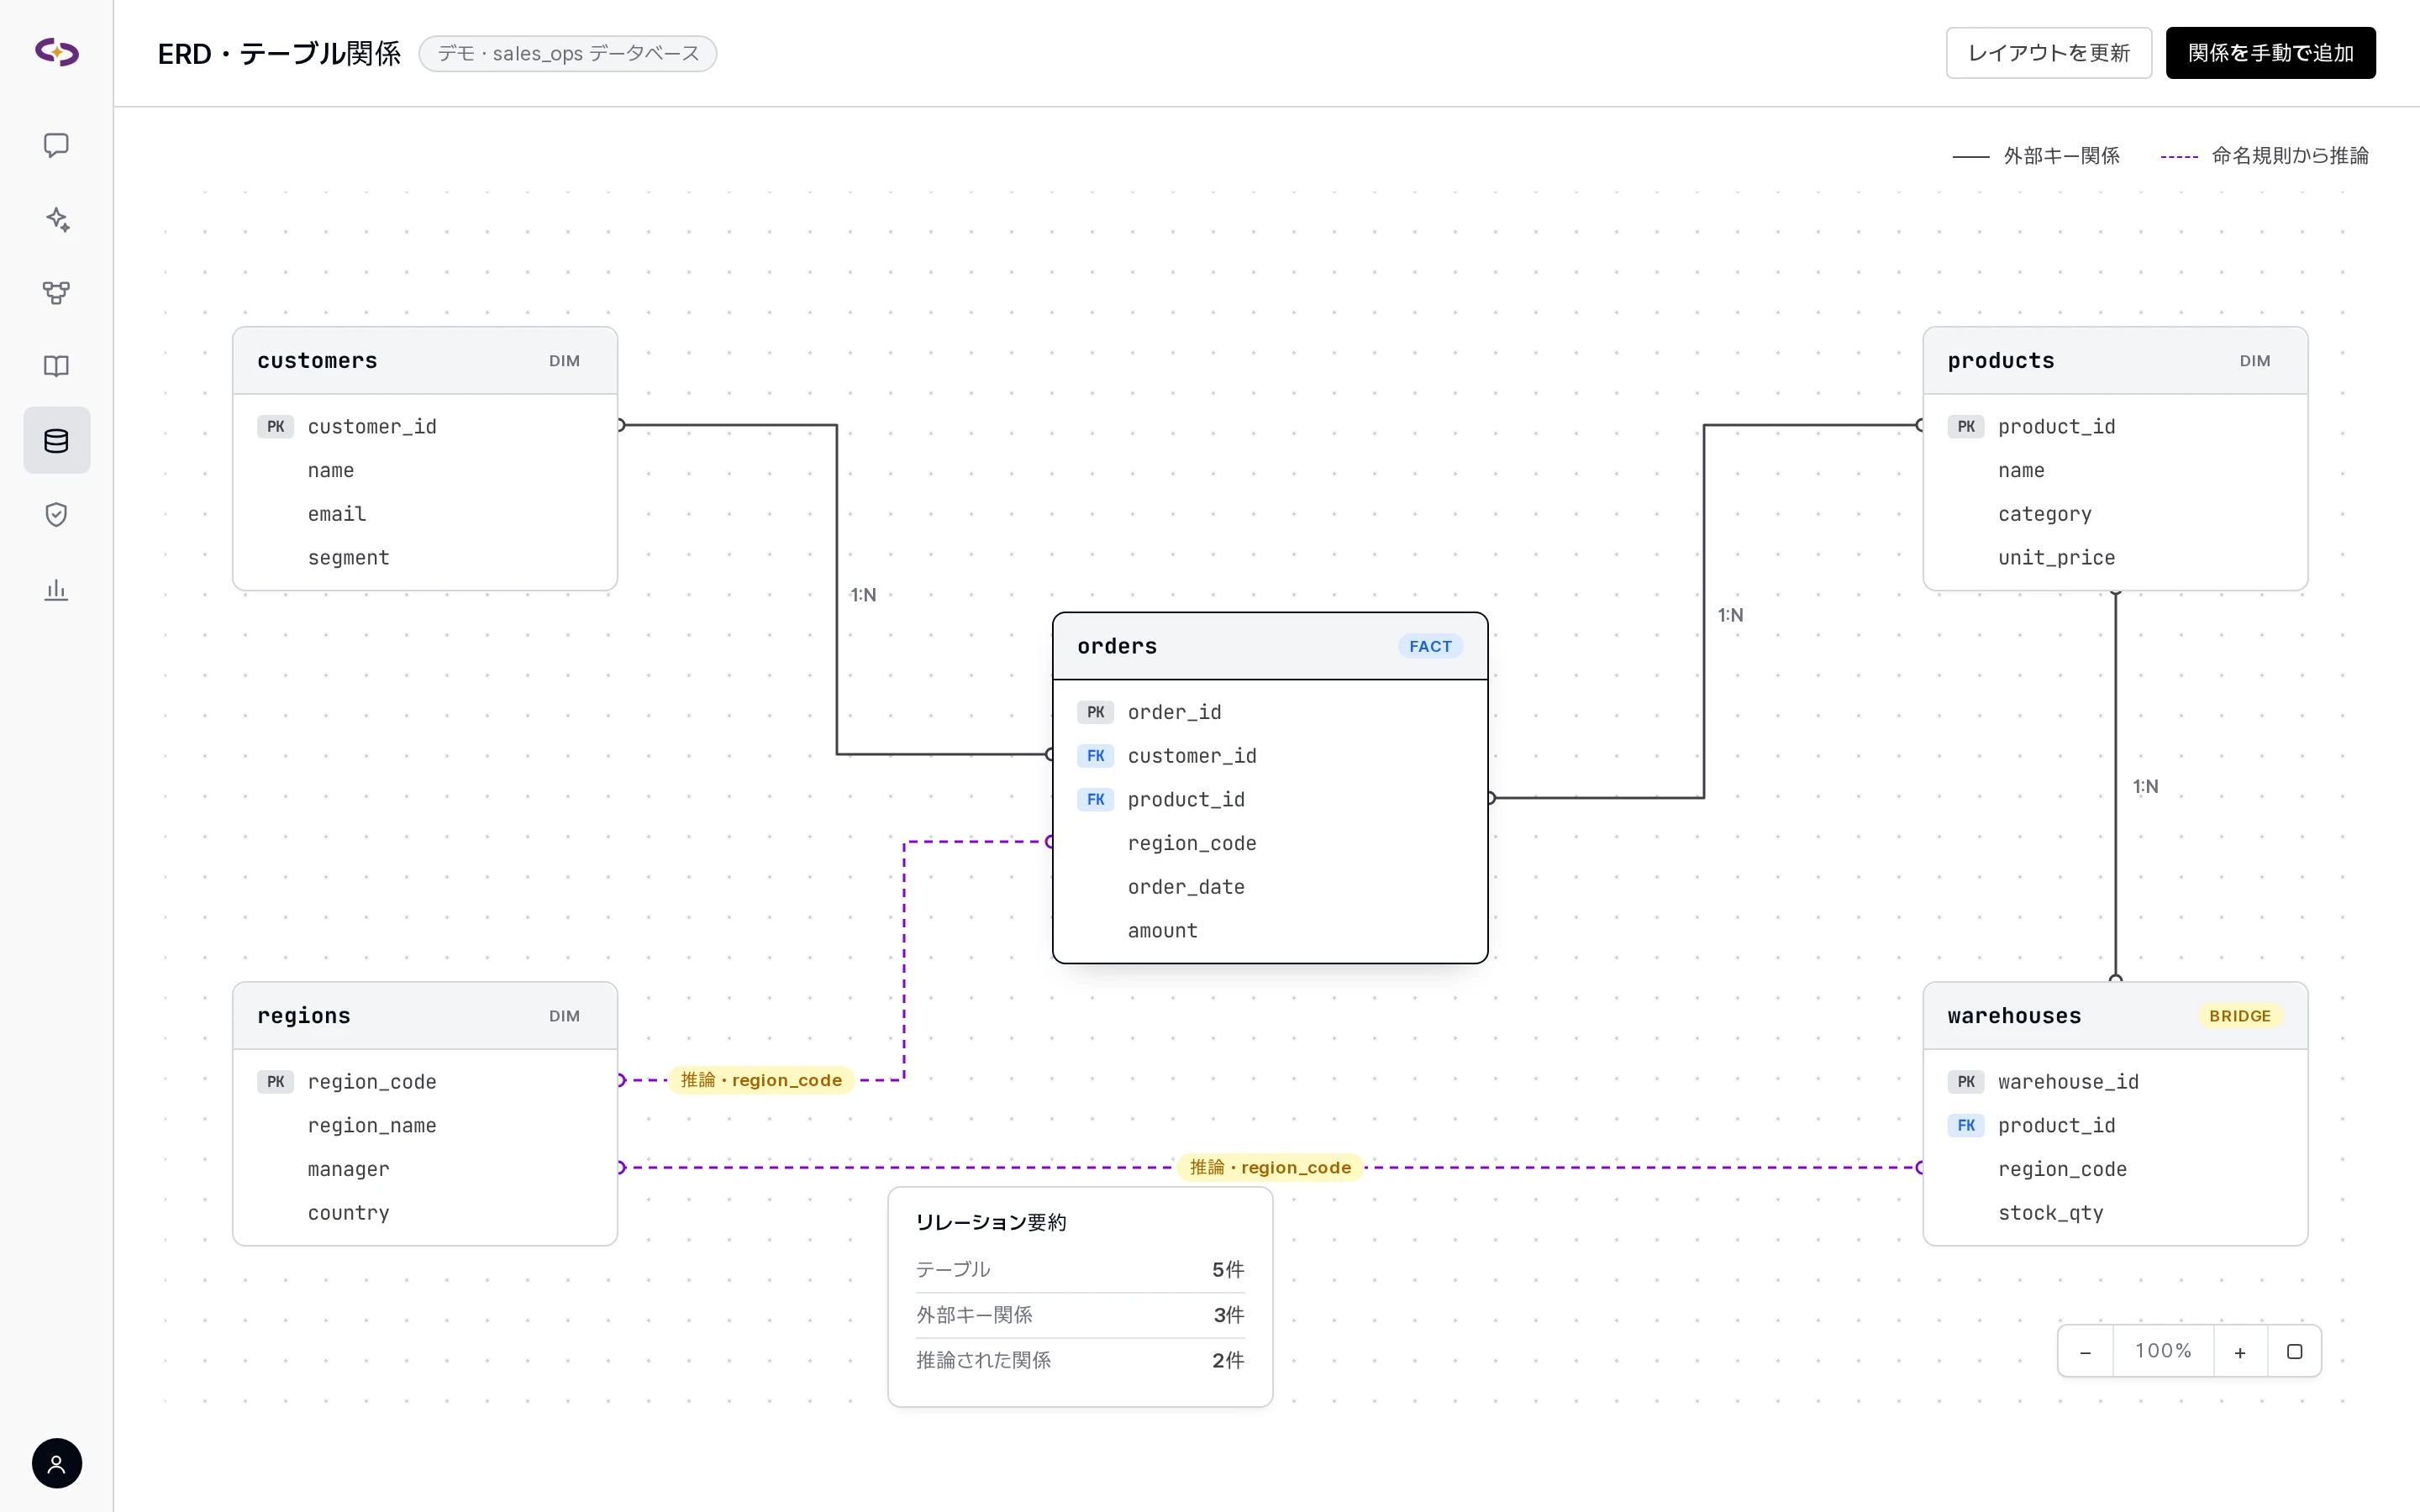
- テーブル関係推論とERD: 外部キーとカラム命名規則からテーブル関係を推論して結合グラフを作成し、ERDパネルでファクト・ディメンション・ブリッジテーブルの役割を確認します。
- SQLエディタ: 画面上で直接SQLを作成・実行し、ファイルとして保存します。
- 書き込みクエリの承認: INSERT・UPDATE・DELETEはプレビュー後に承認して初めて反映され、DBごとに書き込みの可否を設定します。実行・承認・却下の履歴はSQL実行記録に残ります。
- AIダッシュボード: 自然言語でパネルを作成するとSQLが生成・検証され、以降は保存されたSQLで更新されます。
用語集
- 社内用語と定義を登録すると、エージェントの回答に反映されます。
- Excel・CSV・Markdownファイルをプレビューしてから一括登録します。形式が異なってもAIが用語項目に変換し、標準テンプレートファイルもダウンロードできます。
- データベースの値から用語候補を抽出し、確認のうえ登録します。
- カテゴリ管理、用語変更のアクティビティ履歴。
ナレッジグラフ
- 用語集のビジネス用語、DBのテーブル・カラム・関係、ナレッジベースの文書を1つのグラフにつなぎます。
- 文書からエンティティと関係を抽出し、用語をカラム条件にマッピングします。例) 「VIP顧客」 →
tier = 'VIP'。 - エージェントにナレッジグラフを接続すると、用語解決・関連テーブル検索・近傍探索のツールが自動的に付与されます。
- グラフを画面上で探索し、ノードタイプ別に絞り込んで検索します。
ナレッジベース・データ分析・用語集の画面
社内規程の質問に根拠の段落で答え、出典の文書とページを添えます。
関連する連携
- データベース8種 → 連携仕様・データベース
- 文書形式・抽出エンジン → 連携仕様・文書形式
- ベクトルDB・検索インデックス5種 → 連携仕様・ベクトルDB
ナレッジベース・用語集はStandardティアから、データ分析・AIダッシュボードはProfessionalティアから、ナレッジグラフはEnterpriseティアに含まれます。 → 料金・ライセンス
関連する更新情報
1.5.0 2026-09
データ分析 検証済みSQLのみをSQL生成用の例(few-shot)として保存
1.4.0 2026-08
データ分析 複数データベースを接続したエージェントの選択根拠表示
1.3.0 2026-07
ナレッジベース ナレッジベースライブラリ